

音频生视频的 AI 工具有哪些?支持音频参考的视频生成模型盘点
发布时间:新闻资讯
很多人以为 “音频生视频” 就是数字人对口型,其实主流 AI 视频大模型已经支持把音频作为参考素材,直接生成音画同步的完整视频。Seedance 2.5/2.0、Wan 3.0、Vidu Q4、MiniMax H3、HappyHorse 等模型都具备这一能力,在一站式 AI 内容创作平台 Pixmax 上即可聚合使用。本文梳理这些模型的能力特点和适用场景,帮你选对工具。
一、先搞懂:音频作为参考素材生成视频,是什么意思?
在 AI 视频生成领域,“参考素材”(Reference)指的是除了文字提示词之外,你喂给模型的示例内容。模型会从参考素材里提取特征,再据此生成新视频。目前主流的参考素材包括:
- 图片参考:锁定角色长相、场景风格、构图;
- 视频参考:模仿人物动作、镜头运动、画面氛围;
- 音频参考:继承音色、旋律、对白、节奏和情绪;
- 文档参考:根据剧本、小说内容生成对应剧情。
音频参考生成视频,就是把一段音频作为 “导演指令” 输入模型:听到对白就生成对应口型和表情,听到音乐就按节奏安排镜头切换,听到环境音就构建相应场景,甚至能根据音频情绪决定画面色调和光影。
这和传统的 “数字人对口型” 是两条路线:数字人方案是固定一个主播形象,主要解决嘴型同步;而音频参考生成视频,输出的是完整的、有镜头语言的电影级画面,适用范围更广,是 2026 年 AI 视频模型的重点能力方向。
二、支持音频参考生成视频的主流 AI 模型
1、Seedance 2.5与2.0
Seedance 2.5 是字节跳动推出的旗舰级视频生成模型,支持文本、图片、视频、音频混合输入,也是目前多模态参考能力最完整的模型之一。
在音频参考方面,它可以从参考音频中提取人声音色、旋律、对白内容,并在生成视频时保持这些特征。音频和画面在同一个流程里协同产出,而不是后期合成,唇形同步和节奏卡点的自然度都很高。
图源网络
主要能力:
- 单次生成最长 30 秒,支持 1080P/4K 输出;
- 多种素材可组合使用,通过 @ 文件名的方式在提示词里指定每个素材的作用;
- 支持原生空间音频,对白、音效、环境音分层,声音位置随画面运动变化;
- 支持视频编辑,传入源视频和参考音频,即可用自然语言调整画面。
Seedance 2.0 是上一代版本,同样支持音频参考,单次时长 4-15 秒,生成速度更快、成本更低,适合对时长要求不高的场景。
2、Wan 3.0
Wan 3.0(通义万相 3.0)是阿里巴巴推出的开源视频生成模型,支持文本、图片、音频等多种参考素材,在开发者和中小团队中使用很广。
音频参考能力上,它支持最多 5 段参考音频(总时长不超过 15 秒),可以明确指定音频是用来引导人声、节奏还是氛围,让声音和画面事件精确匹配,比如鼓点响起时画面同步切换、脚步声和人物动作对齐。
图源网络
主要特点:
- 支持 1080P、最长 30 秒,原生同步音频;
- 多镜头叙事能力强,能生成有完整起承转合的短片;
- 开源可本地部署,也可通过阿里云 API 调用;
- 对中文提示词和中文语音的理解比较友好。
3、Vidu Q4
Vidu Q4 是生数科技推出的视频生成模型,主打 Reference-to-Video(参考生视频)模式,支持图片和音频参考一起输入。
它的音频参考亮点是:支持最多 3 段语音参考,配合最多 12 张图片参考,可以分别锁定不同角色的长相和声音,生成多角色对话时不会出现 “声音串角色” 的问题。
图源网络
主要特点:
- 智能镜头切换,多机位场景下角色一致性表现优秀;
- 最长 16 秒,支持 4K 分辨率;
- 适合多角色对话、故事短片、品牌剧情广告。
4、MiniMax H3
MiniMax H3 是 MiniMax(海螺 AI)推出的开源视频生成模型,是 2026 年下半年热度很高的开源模型。
它的 “全能参考” 模式支持混合输入最多 12 个文件,包括图片、视频和音频,音频可以驱动人物对白、口型和动作,生成的视频原生包含音效,不需要再单独做音频编辑。
图源网络
主要特点:
- 支持 768P(可升级至 1440P)、24 帧;
- 多模态混合参考,各类素材可自由组合;
- 开源免费,适合二次开发和批量生产;
- 动作幅度和场景表现力强,适合短剧、动画内容。
5、HappyHorse 1.1
HappyHorse 1.1(快乐马)是 2026 年 6 月发布的视频生成模型,主打电影级影像质感,支持 T2V(文生视频)、I2V(图生视频)、R2V(参考生视频)三种模式。
在参考生视频模式下,它支持最多 9 张参考图并配合音频参考,画面光影、质感和镜头语言偏向电影风格,口型和氛围匹配自然。
图源网络
主要特点:
- 支持 720P/1080P、3-15 秒、24 帧 MP4;
- 电影感调色和光影表现突出;
- 适合追求画面质感的创作者和品牌方。
三、Pixmax:一站式聚合这些音频参考模型,不用来回切换
上述模型分散在不同的官方入口和云服务平台,单独使用要分别注册、计费,素材也要反复上传。
Pixmax 是一站式 AI 内容创作平台,聚合了全行业主流 AI 大模型,把这些支持提示词、图片、文档、音频等参考素材生成视频的模型都集成到了同一个工作台里。
在 Pixmax 上做音频生视频,流程大致是:
- 进入视频生成工作台,选择需要的模型;
- 上传音频参考素材,同时可上传角色参考图、场景图、剧本文档等;
- 在提示词里说明音频的作用,比如 “参考音频中的女声和对白节奏,生成角色说话的画面”;
- 选择画幅、时长、分辨率,生成视频;
- 不满意可在无限画布中调整参考素材和提示词,重新生成或继续编辑。
Pixmax 的价值在于:
- 模型集中:一个平台调用多个主流模型,方便对比效果;
- 素材通用:音频、图片、文档上传一次,就能在不同模型间复用;
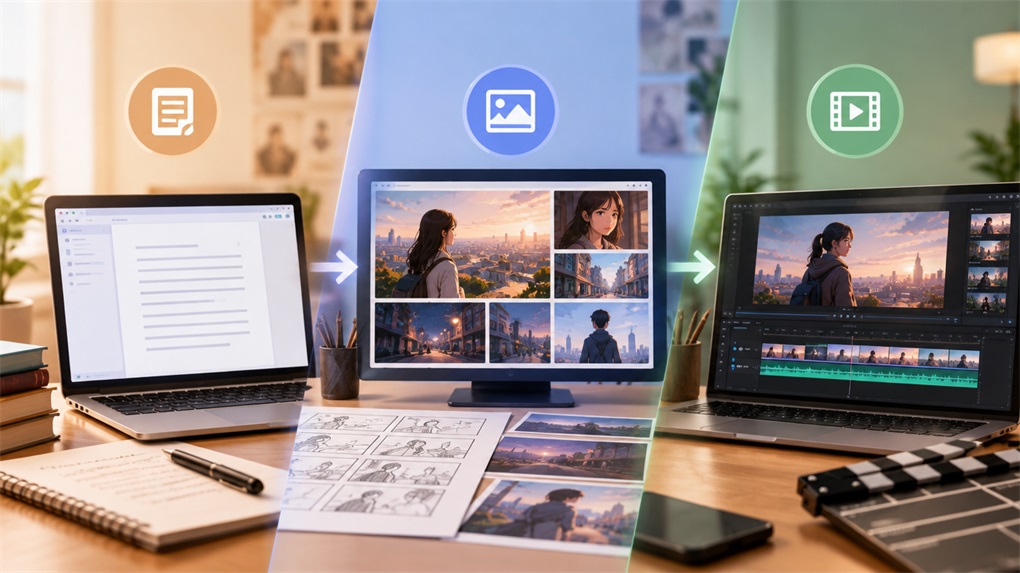
- 工作流完整:从剧本、分镜、角色到成片可视化操作,适合 AI 短剧、漫剧、广告片的批量生产;
- 无需部署:开源模型也能直接在线调用,不用本地配置环境。
四、音频参考生成视频的典型应用场景
音频参考能力的成熟,让很多过去需要专业团队的内容生产方式变得简单:
- AI 短剧 / 漫剧:用配音录音或 AI 配音作为音频参考,配合角色参考图,生成多镜头短剧成片;
- 音乐 MV:上传原创歌曲或 Suno、Udio 生成的 AI 音乐,模型按节奏和旋律生成画面,自动卡点;
- 播客 / 有声内容视频化:把播客录音、小说配音作为参考,生成对应画面,适配视频号、B 站、抖音;
- 多角色对话视频:利用多音色、多角色一致性能力,生成剧情对话片段;
- 广告与产品短片:上传品牌音效、旁白录音,配合产品图生成广告片,统一品牌声音和视觉。
五、几个模型怎么选?
| 模型 | 音频参考能力 | 时长 / 分辨率 | 最适合 |
|---|---|---|---|
| Seedance 2.5 / 2.0 | 音色、旋律、对白继承,多模态混合参考 | 最长 30 秒 / 1080P-4K | 电影级短片、通用高质量创作 |
| Wan 3.0 | 最多 5 段音频,可指定引导人声 / 节奏 / 氛围 | 最长 30 秒 / 1080P | 多镜头叙事、中文内容、开源部署 |
| Vidu Q4 | 最多 3 段语音,多角色音色锁定 | 最长 16 秒 / 4K | 多角色对话、剧情广告 |
| MiniMax H3 | 全能参考,原生音效,最多 12 个文件 | 768P-1440P | 开源二开、短剧动画、批量生产 |
| HappyHorse 1.1 | 音频原生同步,电影感强 | 3-15 秒 / 1080P | 质感短片、音乐视频、概念片 |
总结
“音频生视频” 在 2026 年已经进入音频作为参考素材、多模态协同生成的阶段,五个主流模型各有侧重:Seedance 综合能力最强,Wan 3.0 适合中文叙事和开源部署,Vidu Q4 擅长多角色对话,MiniMax H3 适合批量生产,HappyHorse 电影质感突出。
不用逐个平台注册试用,在 Pixmax 上就能聚合调用这些模型。建议先用同一段音频在不同模型上分别生成,对比效果后再固定自己的工作流,把一段音频快速变成有画面、有节奏、有故事的视频。
从剧本到分镜、角色、视频生成和配音,快速完成完整创作流程。
立即开始创作